简单base64
来源-CTFshow
这道题首先展示了一个登录界面,如下图所示:
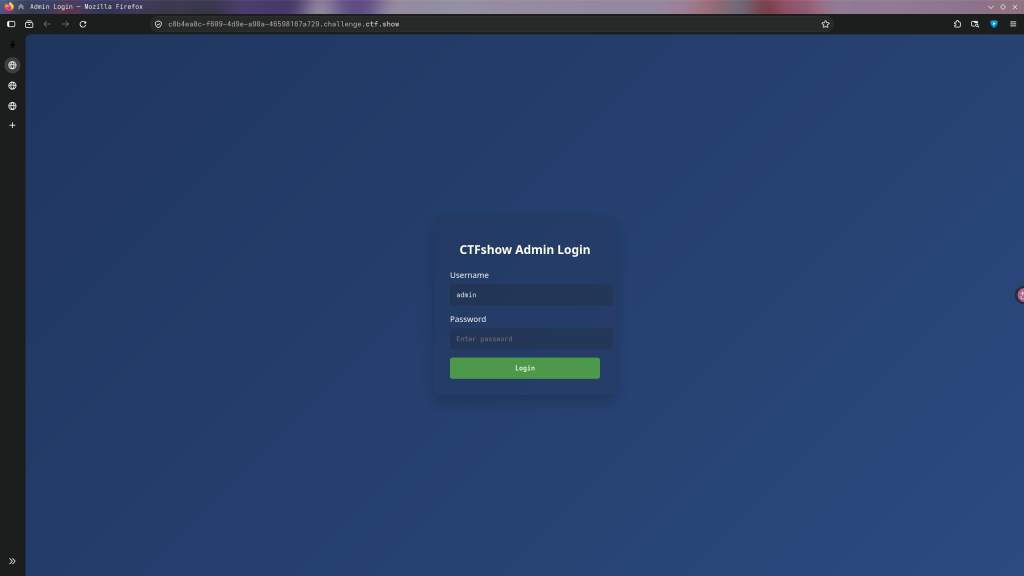
题目提示 代码 隐藏,我下意识按下了 Ctrl+U 查看源代码,发现
<script>
        document.getElementById('loginForm').addEventListener('submit', function(e) {
            e.preventDefault();

            const correctPassword = "Q1RGe2Vhc3lfYmFzZTY0fQ==";
            const enteredPassword = document.getElementById('password').value;
            const messageElement = document.getElementById('message');

            if (btoa(enteredPassword) === correctPassword) {
                messageElement.textContent = "Login successful! Flag: "+enteredPassword;
                messageElement.className = "message success";
            } else {
                messageElement.textContent = "Login failed! Incorrect password.";
                messageElement.className = "message error";
            }
        });
    </script>
加粗部分定义了一个常量,正确密码用 b64 直接硬编码到网站脚本源码里。直接将这部分内容解码就得到了正确答案
❯ echo "Q1RGe2Vhc3lfYmFzZTY0fQ==" | base64 -d
CTF{easy_base64}%
HTTP请求头伪造&Burp使用
这道题同时也让我进一步学习了BurpSuite的用法,对我还是很有帮助的
来源-CTF秀
访问网站,发现还是上一道题的页面,查看源码,发现在脚本部分的密码还是没变,输入进去:
报错:需要 “ctf-show-brower” 浏览器(啊对,最后一个单词是 brower 而不是 browser )
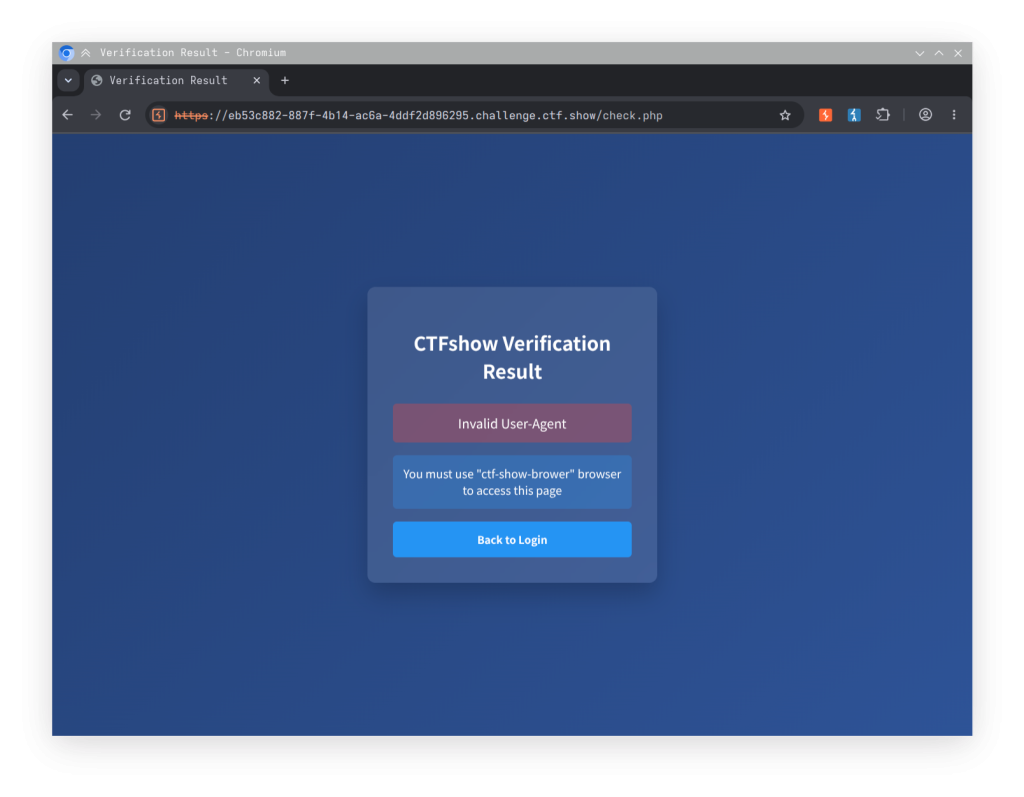
你觉得我新生赛做了三遍摸金能不知道该怎么办?
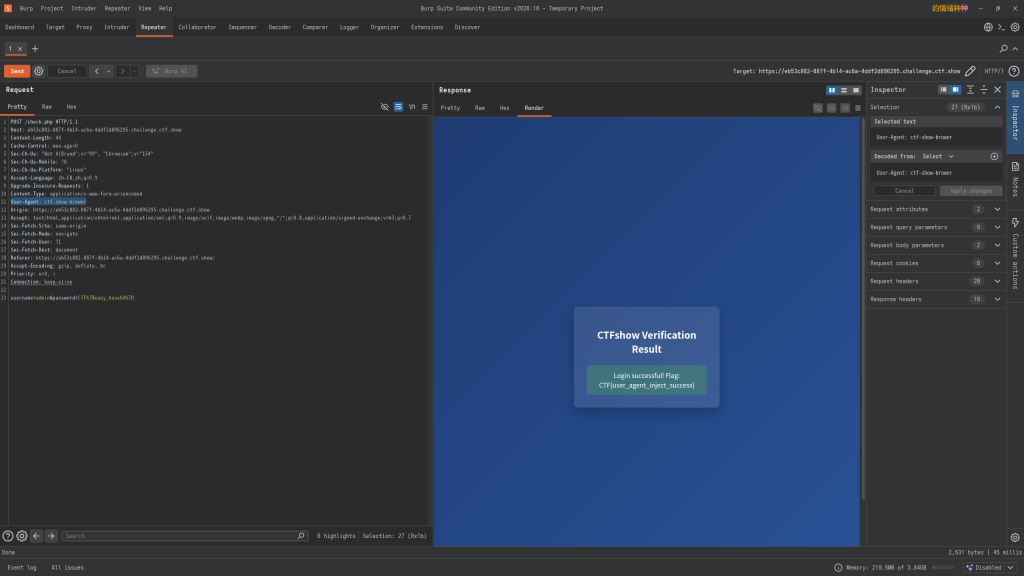
那还说啥了,直接丢到 Brup/Repeater 里改 UA
总结
这道题简单让我们伪造了一下请求头上的内容,本题仅让我们改了 UA ,没有改其他部分。为了做功课,不妨将请求头中可以改的东西直接列出并提供例子(理论知识)
我意识到我的网站服务器可以当一个简单靶机,自己写 php 自己测试,有意思。
但是这需要编程基础,所以这里插个眼,回头再搞
可以改的部分:
- User-Agent: <用户代理> “我用的什么”,通常是各家浏览器。一个常见的实践是:识别你是不是从微信来的(微信的 UA 总是携带 MicroMessage 字样)
- Referer: <来源链接> “我从哪里来”,指示用户是从哪里跳转到访问的链接的,我猜测 WordFence 建立插件与博客网站之间的联系用的就是这个
- Cookies: <文本> “我带着什么标签”,通常是用来标识用户身份,比如登录状态、会员等级什么的,比如山科大安全教育网站就是这么做的
- X-Forward-For: <ip>“我的IP是”,自报家门,服务器如果信任的话就是无条件信任。因为太容易被伪造所以现在的服务器基本不信了。
Base64嵌套加密
来源-CTFshow
本题目属于本身简单但是比较吃基础的那种
(猫猫KV档案室还在追我),所以本笔记中,做题过程不是重点。由此链接到的知识才是最重要的。
会用到的知识
- Base64原理
- Python基本语法
- Python Base64库
- Javascript 基本语法
会用到的工具
- Cyberchef——全方位WEB工具集……不学CTF也很好用
- BurpSuite
Base64原理
参考更多:
- 维基百科-Base64(您可能需要一些手段才能访问)(约 5 分钟)
- 柴知道-锟斤拷�⊠是怎样炼成的——中文显示“⼊”门指南-bilibili(约 15 分钟)
介绍:
Base64是一种将 二进制 数据转化成可打印字符(通常是 Ascii 字符,后简称“字符”)的一种编码方法
编码规则:
按照预先确定好的编码表(映射表),每 6bit数据 编码成 1个字符 ,而一字节数据是 8bit 。因为 6(一个Base64单元) 和 8(一个Ascii字符编码单元) 的最小公倍数是 24 ,所以Base64的运作方式是……
每 3字节数据 编码成 4个字符 ,不足三字节的部分使用 0 补齐,同时在输出中用 “=” 补充。最后出来一串长度是 4的倍数(4n) 字符的文本。
base64支持的编码字符集是:26个英文字母(大小写共 52 个)、0~9 阿拉伯数字(10 个)、+ / = 3 个特殊字符,其中 “=” 的作用类似占位符。共计 65个 字符。
比如下面这些例子:
❯ echo “goledenglow” | base64
Z29sZWRlbmdsb3cK
❯ echo “goledenglow0” | base64
Z29sZWRlbmdsb3cwCg==
❯ echo “Goledenglow0” | base64
R29sZWRlbmdsb3cwCg==
❯ echo “GOledenglow0” | base64
R09sZWRlbmdsb3cwCg==
❯ echo “GOledenglow000000000000000000000” | base64
R09sZWRlbmdsb3cwMDAwMDAwMDAwMDAwMDAwMDAwMDAK
❯ echo “goledenglow000000000000000000000” | base64
Z29sZWRlbmdsb3cwMDAwMDAwMDAwMDAwMDAwMDAwMDAK
#b64解码
❯ echo "Z29sZWRlbmdsb3cwMDAwMDAwMDAwMDAwMDAwMDAwMDAK" | base64 -d
goledenglow000000000000000000000
❯ echo "Z29sZWRlbmdsb3cwMDAwMDAwMDAwMDAwMDAwMDAwMDA" | base64 -d
goledenglow000000000000000000000
❯ echo "Z29sZWRlbmdsb3cwMDAwMDAwMDAwMDAwMDAwMDAw" | base64 -d
goledenglow0000000000000000000
❯ echo "Z29sZWRlbmdsb3cwMDAwMDAwMDAwMDAwMDAwMDA" | base64 -d
goledenglow000000000000000000
❯ echo "Z29sZWRlbmdsb3cwMDAwMDAwMDAwMDAwMDAwMD" | base64 -d
goledenglow00000000000000000base64: 无效的输入
❯ echo "Z29sZWRlbmdsb3cw" | base64 -d
goledenglow0
❯ echo "9sZWRlbmdsb3cw" | base64 -d
��VFV�v��s
对于CTF题目中,我们最常处理的当然是 字符串
有两点需要注意:
- 字符/字符串 仅仅只是存储了对应的 “形态”,丢进base64会直接不认。这时候就要对字符串里的每个字符进行 编码 到二进制数据后再丢进base64(啊对,双重编码)。光这个字符集编码就够单开一篇来讲了……有兴趣的话请前往本节首部的 参考更多
- 以中文为首的象形文字因为更复杂
(东亚三兄弟这一块),每个字符占用 2 个字节!!!请看:
❯ echo "." | base64
#    Lgo=
❯ echo "。" | base64
#    44CCCg==
总之,目前只需要知道现在大多数用了base64的系统都使用 UTF-8 编码对字符串处理,而 UTF-8 是 ASCII 的超集,类似 C 与 C++ 之间的关系,所有的合法 ASCII 字符都是合法的 Unicode 字符。除了部分有历史的东西默认不是UTF-8(比如HTML,那家伙默认是 ASCII,你得在编写的时候加上 <meta charset=’UTF-8′> 才行)。
总结一下
base64编码 以三字节为一个单位将二进制数据编为4n个字符文本数据。不足通常在数据中用 0 补位,在输出中使用 = 补位。
Python 基础语法
参考更多:C++命名空间-菜鸟教程
在本题中你主要会使用这些 关键字/函数:
#符号解释:
# <占位符>
# [可选项]
# int 你需要输入整数,循的 C 语法,仅作提示。Python没那么多条条框框
import base64 [as <custom> ]                 #导入base64库
<string var>.encode("<charset::default utf-8>") #对字符串变量编码为二进制数据,没指定方式的话就默认 UTF-8 了
<string var>.decode()                        #和刚才类似,但是是解码
for i in range(<int start>,<int end>):       #进行穷举循环
b64bet = "QWERTYUIOPASDFGHJKLZXCVBNMqwertyuiopasdfghjklzxcvbnm0123456789+/=" #标准 base64 字母映射表
b64bet[x]  # 将会得到 "b64bet" 中第 x+1 个结果  #在 Python 中,字符串同时具有 "字符串" 和 "列表" 两种性质
##在下面的例子中 a 是可以被省略的
b64bet[a:b]  #将会得到 "b64bet" 中第 a+1 到 第 b+1 个字符组成的子字符串
b64bet[a:-b]  #将会得到 "b64bet" 中第 a+1 到 倒数第 b 个字符组成的字符串
##注意! " . " 有两种含义
<lib>.<function>                             #调用 <lib> 库里的 <function> 函数
<data>.<function/action>                     #将上一步的结果直接传给之后的操作当输入
##这部分内容涉及命名空间的概念
base64.b64<action>(<byte 或 string>)          #使用base64库编解码;<action> 是 "encode" 或 "decode"
#--------------进行尝试并忽略合理的报错
try:
  <codes>
except Exception:
  continue
#----------------------------------
#--------------使用 file 对象对文件进行操作,你不会想让一大堆文本挤爆你的终端的
with open("<filename>" , "<action>" , encoding = "<charset>") [ as < yourFavourateName > ]:
Python Base64库
介绍
该库专门用于处理 Base64 数据,我们主要会用到它的 base64 函数,基本用法:
import base64 ;
string = "114514" ;
base64.b64encode(string) ; # 输入字符串,自动编码为 UTF-8 数据并传入,base64编码后传出 ASCII 数据(注意此时还是数据,不能直接拿来用)
#如何直接拿来用
base64.b64encode(string).decode() ; #直接在后面加个解码就可以,因为默认都是 Unicode ,所以中间不用加任何字符集标识
#如果你想加上的话
base64.b64encode(string).decode("utf-8") ; #用单/双引号将你指定的字符集框起来
感觉一堆字母敲起来麻烦还容易出错?确实如此,所以不妨定义一个函数,封装起来,专门处理字符串(进去字符串出来的也是字符串)
def en64(s: str) -> str:
  return base64.b64encode(s.encode()).decode();
def de64(s: str) -> str:
  return base64.b64decode(s.encode()).decode();
之后仅需 en64(<字符串>) 就可以了
在终端环境下进行测试:
❯ python b64BOMB.py
  #SGVsbG9Xb3JsZCE=
  #HelloWorld!
开始做题
打开页面,还是那个简单的后台登录界面,查看源码发现下面的关键代码
const correctPassword = "SXpVRlF4TTFVelJtdFNSazB3VTJ4U1UwNXFSWGRVVlZrOWNWYzU=";
function validatePassword(input) {
                let encoded = btoa(input);
                encoded = btoa(encoded + 'xH7jK').slice(3);
                encoded = btoa(encoded.split('').reverse().join(''));
                encoded = btoa('aB3' + encoded + 'qW9').substr(2);
                return btoa(encoded) === correctPassword;
            }
翻译过来的流程如下(伪代码):
函数 验证用户输入的密码
    对 encoded 进行b64编码;
    加盐"xH7jk",再编码,去掉前三个字符
    反转,再编码
    前加盐"aB3" 并且 后加盐"qW9",去掉前两个字符
    再编码,和正确密码比较
    返回是否正确
所以我们要做的事就是已知答案反推初始值。
此时我们就用上了Cyberchef
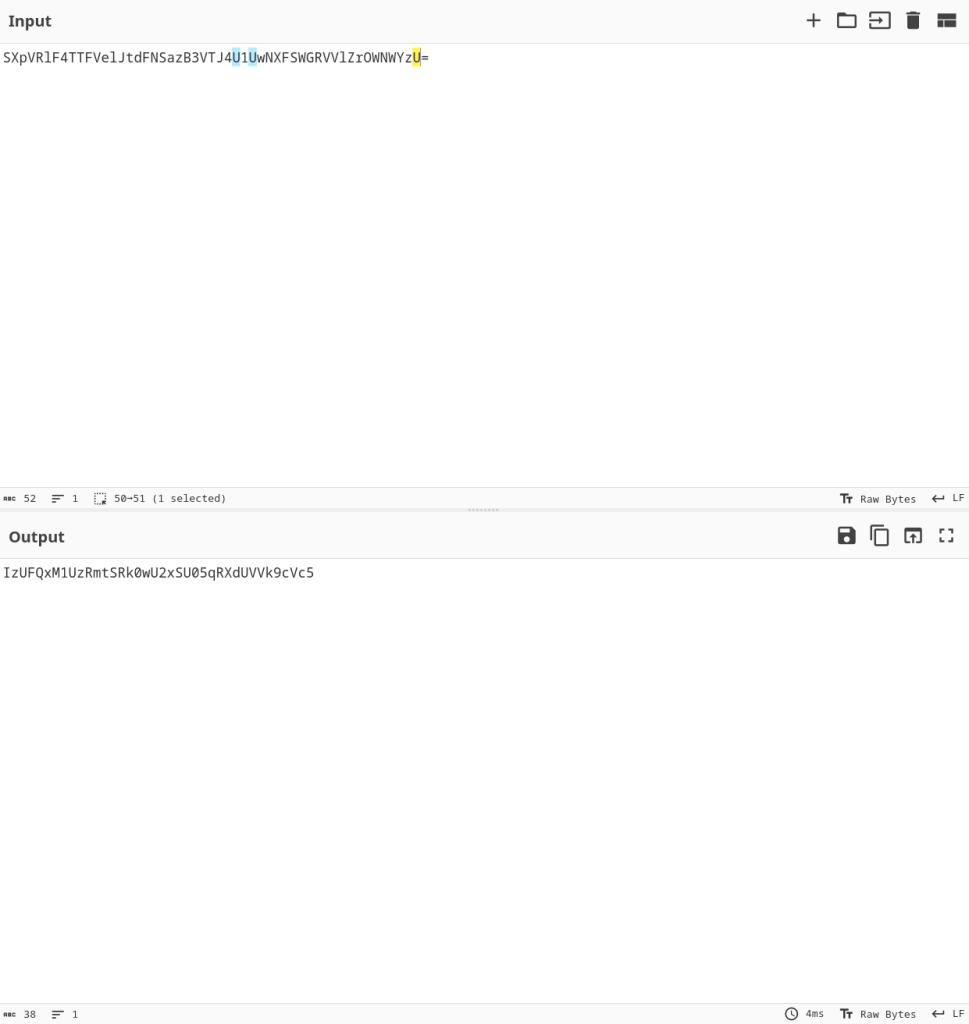
第 0 层已破解:SXpVRlF4TTFVelJtdFNSazB3VTJ4U1UwNXFSWGRVVlZrOWNWYzU= >–>–> IzUFQxM1UzRmtSRk0wU2xSU05qRXdUVVk9cVc5
直接将第 1 层丢过去发现是乱码,因为这根本就不是一个合法的 Base64 内容,这串字符长 38 ,正好在补全2个字符之后就合法了。
由维基百科上的解释可知,拆掉两个字符并不会将原文对应的三个字符全毁掉,能保留一个。所以可以进行补全:
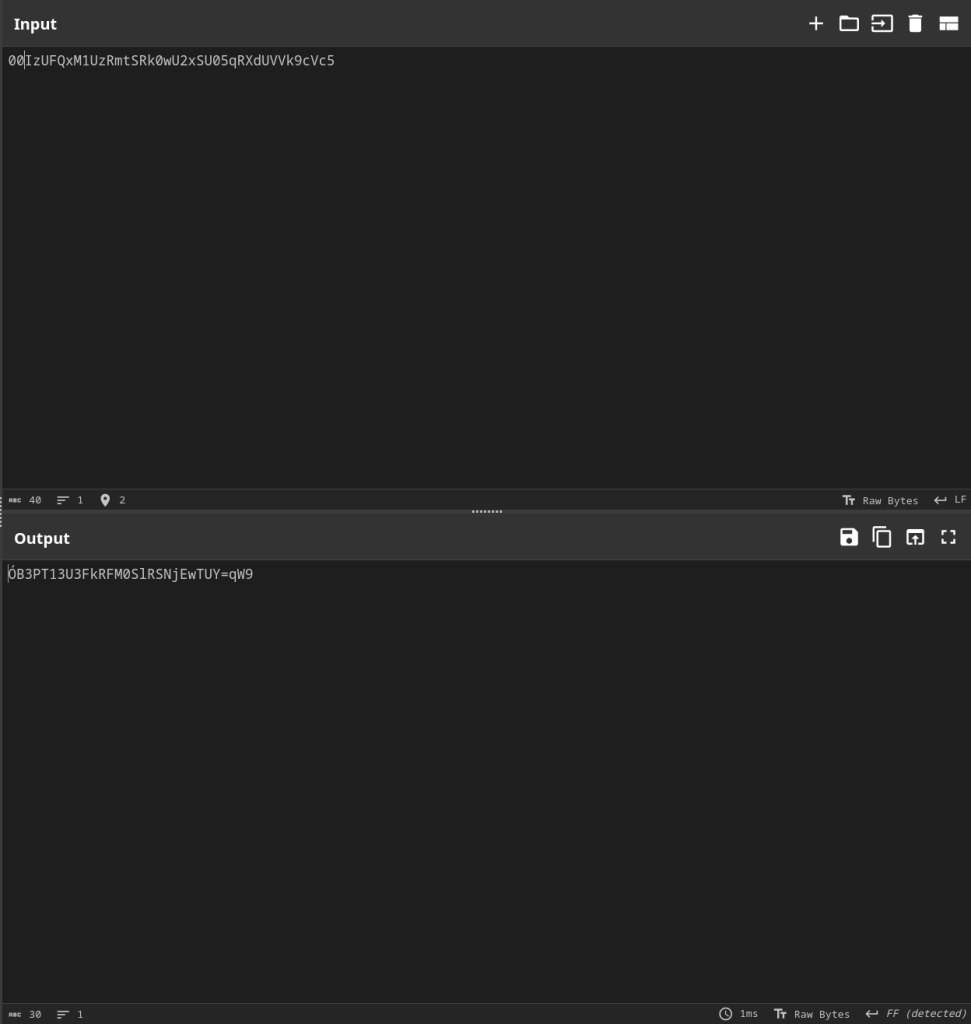
出现了,解码后的第三个字符 “3” 对映的就是原先加的盐 “aB3“, 后面的 “qW9” 也暴露了。由于这只是加盐,所以直接删是没有压力的。
这里直接给出第三层结果,因为第二层仅仅是倒了个个。
FM016RTJ4SDdqSw==
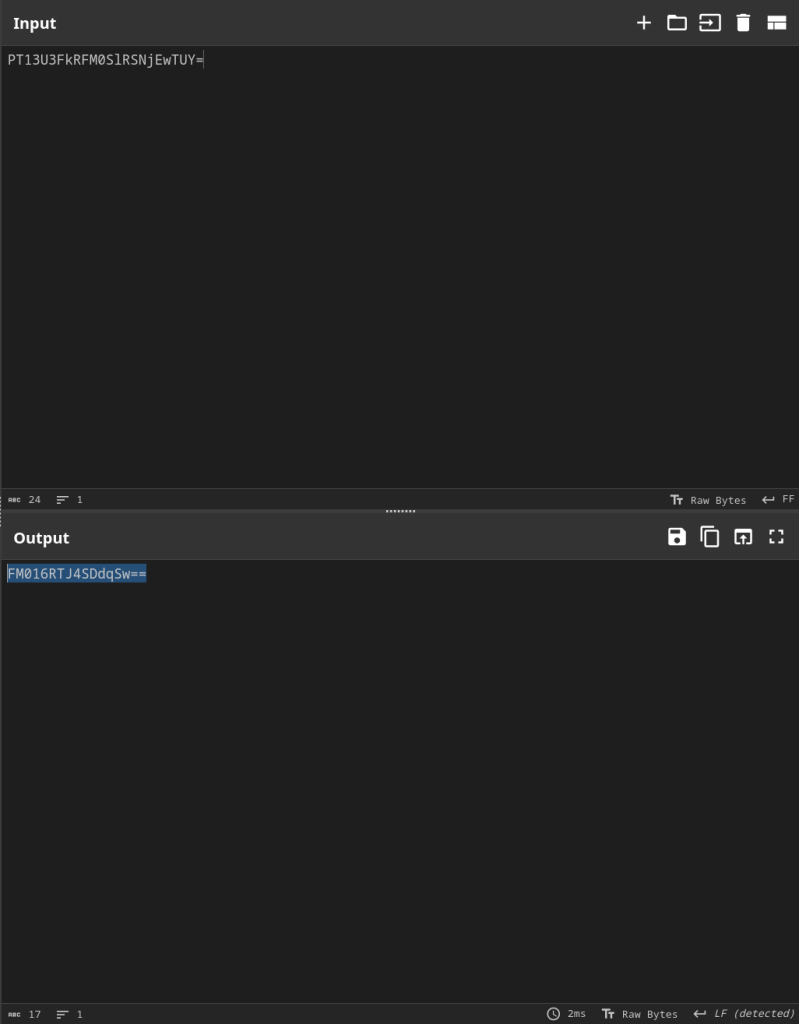
第四层……坏了,这次是后加盐,抠的是前面的,所以没法,只能爆破了
按照参考资料自己复现了一遍脚本
import base64 as b64
#------定义快捷编解码函数---BEGIN
def enb64(s: str) -> str:
    return b64.b64encode(s.encode()).decode(); #base64库可以直接传入ASCII,如果想传入任意字符,需要进行utf-8编码 但是人家会返回字节数据,所以没法直接打印。所以需要进行解码
def deb64(s: str) -> str:
    return b64.b64decode(s.encode()).decode();
#------------------------END
hello = enb64("HelloWorld!");
print(hello);
print(deb64(hello));
base = "FM016RTJ4SDdqSw==";
b64bet="QWERTYUIOPASDFGHJKLZXCVBNMqwertyuiopasdfghjklzxcvbnm0123456789+/";      #base64编解码用的字符表
results = [];
for BOMB0 in b64bet:
    for BOMB1 in b64bet:
        for BOMB2 in b64bet:
            BOMB = BOMB0 + BOMB1 + BOMB2 + base ;
            try:
                r1 = deb64(BOMB);
                r2 = r1[:-5];            #删掉最后5个字符的的盐
                r3 = deb64(r2);
                results.append(r3);
            except Exception:
                continue;
with open("tries.txt","w", encoding="utf-8") as f:
    for GoIn in results:
f.write(GoIn + '\n'); #不要忘记加换行符哦从同目录下的文本文档中找出一串没有乱码的就行。
输入进去,需要改UA,这里不再赘述。
为什么没有乱码可以?
不妨我随便取一个,正推一遍:
❯ echo "YTczMTYKxH7jK" | base64
WVRjek1UWUt4SDdqSwo=
❯ echo "jek1UWUt4SDdqSwo=" | base64
amVrMVVXVXQ0U0RkcVN3bz0K
❯ echo "amVrMVVXVXQ0U0RkcVN3bz0K" | rev | base64
SzB6YjNOVmNrUjBVMFFYVlhWVk1yVm1hCg==
❯ echo "aB3SzB6YjNOVmNrUjBVMFFYVlhWVk1yVm1hCg==qW9" | base64
YUIzU3pCNllqTk9WbU5yVWpCVk1GRllWbGhXVmsxeVZtMWhDZz09cVc5Cg==
❯ echo "IzU3pCNllqTk9WbU5yVWpCVk1GRllWbGhXVmsxeVZtMWhDZz09cVc5Cg==" | base64
SXpVM3BDTmxscVRrOVdiVTV5VldwQ1ZrMUdSbGxXYkdoWFZtc3hlVlp0TVdoRFp6MDljVmM1Q2c9
PQo=
随便找的一个是可行的
至于原理,我严重怀疑是中间的截取字符串发力了,因为在截取b64码文的时候会不可避免的损失一些数据,而原来的JS代码中上来就给开头一两个字符的原始数据敲掉了。
导致的结果就是:你输入的密码中,开头的一两个字符 根本就不是密码的一部分 ,只要保证能过 base64 就可以!